
TYPO3 ist in Deutschland nach WordPress das am zweithäufigsten eingesetzte Content-Management-System [1]. Viele TYPO3-Websites gehören Verwaltungen, Hochschulen, Verbänden und mittelständischen Unternehmen, deren Seiten Fragen zu eher komplexen Sachverhalten wie Zuständigkeiten, Anträgen, Studiengängen und Produkten beantworten. Gleichzeitig nutzen 34 Prozent der Menschen in Deutschland ab 16 Jahren mindestens einmal pro Woche KI-Anwendungen [2] und stellen ihre Fragen zunehmend an Systeme wie ChatGPT, Perplexity oder Microsoft Copilot. Klicks verschwinden zunehmend und die Informationsbeschaffung kann bereits im LLM oder in der KI-Antwort auf Google enden. Für Organisationen mit TYPO3-Website stellt sich damit die strategische Frage, wie sich Generative Engine Optimization umsetzen lässt um somit weiterhin eine dominante Quelle für KI-Antworten zu wichtigen Themen und Konzepten zu sein und interessierten Nutzer*innen über eine direkte Erwähnung in KI-Antworten als direkt zugängliche Quelle auffindbar zu sein.
Generative Engine Optimization soll TYPO3-Inhalte in KI-Antworten zitierfähiger machen
Verbindliche Richtlinien für GEO haben die Anbieter von KI-Suchsystemen bislang nicht veröffentlicht. Google beschreibt in seinem Leitfaden vom Juli 2026 die Mindestanforderungen für AI Overviews und AI Mode wie folgt: Eine Seite muss indexiert sein und für Snippets in der Google-Suche infrage kommen, spezielle KI-Dateien oder ein eigenes Schema.org-Markup verlangt Google nicht [4]. Der Leitfaden gilt für die (KI-gestützte) Google-Suche und trifft keine Aussage über ChatGPT, Perplexity, Claude oder Copilot. Die Maßnahmen in diesem Beitrag beruhen deshalb primär auf Studien, Empfehlungen bzw. Erfahrungen aus der Praxis und Messungen, die sich (Stand September 2026) mit der Entwicklung der KI-Systeme laufend ändern können. Die allgemeinen Grundlagen von GEO erklärt der Beitrag Generative Engine Optimization: Definition, Funktionsweise und technische Grundlagen für Unternehmen.
Die Umsetzung von GEO in TYPO3 lässt sich in der Praxis auf drei Ebenen gliedern: die technische Auslieferung der Seiten, die Ausgabe strukturierter Daten und die redaktionelle Struktur der Inhalte.
Tipp: Machen sie den kostenlosen GEO-Test von SinusQuadrat für Ihre TYPO3-Seite.
TYPO3-Websites profitieren davon, GEO im nächsten Upgrade oder Relaunch mitzuplanen
Rund 40 Prozent der TYPO3-Websites laufen auf den Versionen 11 und 12 [1], für die das TYPO3 Core Team seit April 2026 keinen kostenlosen Support mehr leistet [5]. Ein Upgrade auf TYPO3 v14 steht für diese Websites daher ohnehin an und berührt Templates, Extensions und Datenmodelle, mitunter an dieselben Stellen, an denen GEO ansetzt. Websites von Verwaltungen, Hochschulen und Verbänden sind erfahrungsgemäß oft aufwendiger in der Anpassung als viele Unternehmenswebsites: Freigaben laufen über mehrere Stellen, und Relaunch-Zyklen erstrecken sich über Jahre. Werden Schema.org-Zuordnung, zitierfähige Inhaltselemente und der Zugang für KI-Crawler im Upgrade gleich mitgeplant, lässt sich ein zweiter Eingriff in dieselben Strukturen vermeiden.
TYPO3 liefert serverseitig gerendertes HTML und ist vorteilhaft beim Crawling durch KI-Systeme
Zuverlässig serverseitig gerendertes HTML gilt nach aktuellem Messstand als eine sicherere Grundlage für die Sichtbarkeit in KI-Suchsystemen, weil mehrere KI-Crawler JavaScript nach bisherigen Beobachtungen nicht ausführen [6],[7]. Anbieter dokumentieren ihr Rendering-Verhalten nur teilweise, und das Verhalten kann sich mit neuen AI-Crawler-Versionen ändern.
TYPO3 rendert Seiten standardmäßig serverseitig über die Template-Engine Fluid, sodass der Inhalt im ausgelieferten HTML steht, sofern Extensions einzelne Bereiche nicht per JavaScript nachladen. Bei Headless-Setups mit TYPO3 hängt die Lesbarkeit für KI-Crawler davon ab, ob das Frontend die Inhalte serverseitig ausliefert oder erst im Browser per JavaScript lädt.
| Kriterium | TYPO3 | WordPress | Headless-CMS |
| Rendering | serverseitig über Fluid | serverseitig über PHP-Themes | abhängig vom Frontend; reines Client-Side-Rendering ist für mehrere KI-Crawler nach aktuellem Messstand nicht lesbar [6, 7] |
| Strukturierte Daten | Extension „schema“ mit JSON-LD-Ausgabe, API und ViewHelpern [8]; Datenmodelle und Zuordnung zu Schema.org-Typen projektspezifisch | Yoast SEO, seit März 2026 zusätzlich mit Schema Aggregation, die alle strukturierten Daten einer Website über einen Endpunkt bereitstellt [9] | im Frontend umzusetzen |
| llms.txt | Extensions „ai-llms-txt“ für TYPO3 v13 und v14 [10] sowie „llms-txt“ von rtfirst | Funktion in der kostenlosen Version von Yoast SEO [11] | im Frontend oder im Build-Prozess zu erzeugen |
| Mehrsprachigkeit (relevant bei mehrsprachigen Websites) | hreflang-Tags automatisch über die Systemerweiterung „seo“ [12]; eindeutige Adresse je Sprachversion über die Site Configuration [3] | hreflang über Plugins wie WPML oder Polylang [13] | abhängig vom Frontend |
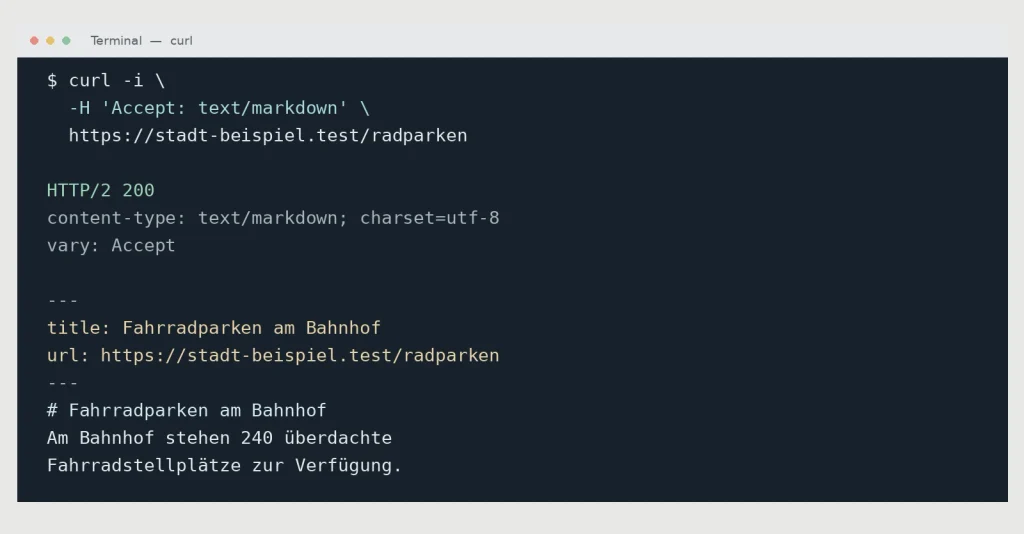
TYPO3 bietet in seiner technischen Funktionsweise daher sogar von Haus aus Vorteile für interessante Funktionen, die bei GEO eine Rolle spielen können. Ein Beispiel ist Content Negotiation: Ein Client gibt im Accept-Header an, welches Format er bevorzugt, und erhält bei der Angabe text/markdown dieselbe Seite als Markdown statt als HTML. Markdown ist ein schlankes Textformat, das KI-Systemen wenig Datenballast liefert. Auch z.B. Cloudflare bietet seit Februar 2026 eine automatische Umwandlung von HTML in Markdown für solche Anfragen an [14]. Für TYPO3 v13 und v14 liefert die Extension „ai-bots-love-markdown“ von b13 Seiten als Markdown mit Metadaten aus und kündigt die Markdown-Version über <link rel=“alternate“> an, was nach Angabe des Hersteller und im praktischen Diskurs für AI-Crawler als messbar attraktiver angegeben wird. [15],[16]
Dieselbe serverseitige Kontrolle erlaubt weitere Bausteine für ein KI-taugliches Web: Die Extension „indexnow“ meldet geänderte Seiten automatisch an Bing und weitere teilnehmende Suchmaschinen [17], ein Entwurf der Internet Engineering Task Force (IETF) sieht einen HTTP-Header „Content-Usage“ vor, mit dem Websites die Nutzung ihrer Inhalte für KI-Training und Suche getrennt steuern können [18], und mit WebMCP ist ein Browser-Standard in Vorbereitung, über den Websites Funktionen wie Suche oder Formulare für KI-Agenten bereitstellen [19]. Für WebMCP existiert auch bereits eine experimentelle TYPO3-Extension [20].
GEO in TYPO3 erfordert individuelle Extensions, Logiken und Datenmodelle
WordPress bietet für GEO mehr fertige Funktionen per Plugin, TYPO3 bietet mehr Automatismen im Core und verlangt für GEO einen höheren Anteil an Handarbeit. Dies ermöglicht aber auch gleichzeitig eine höhere Qualität: Plugins wie Yoast in WordPress übernehmen GEO Aufgaben oft vollautomatisch, sind aber massenhaft im Internet vorhanden und oft unsauber aufgebaut [9, 11]. In TYPO3 entstehen vergleichbare Funktionen über Extensions wie „schema“ oder „ai-llms-txt“, deren Konfiguration an die Seitenstruktur und die Datensätze der jeweiligen Website angepasst werden muss [8, 10]. Viele TYPO3-Websites arbeiten mit eigenen Datenmodellen, etwa für Veranstaltungen, Standorte, Studiengänge oder sonstige Leistungen. Damit KI-Systeme solche Inhalte leichter als eindeutige Themen, Orte oder Personen erkennen können, sollten die Felder der Datenmodelle den passenden Schema.org-Typen zugeordnet und die strukturierten Daten wenn möglich aus den Datensätzen automatisch erzeugt werden.
Strukturierte Daten gelten als ein möglicher Hebel für GEO in TYPO3
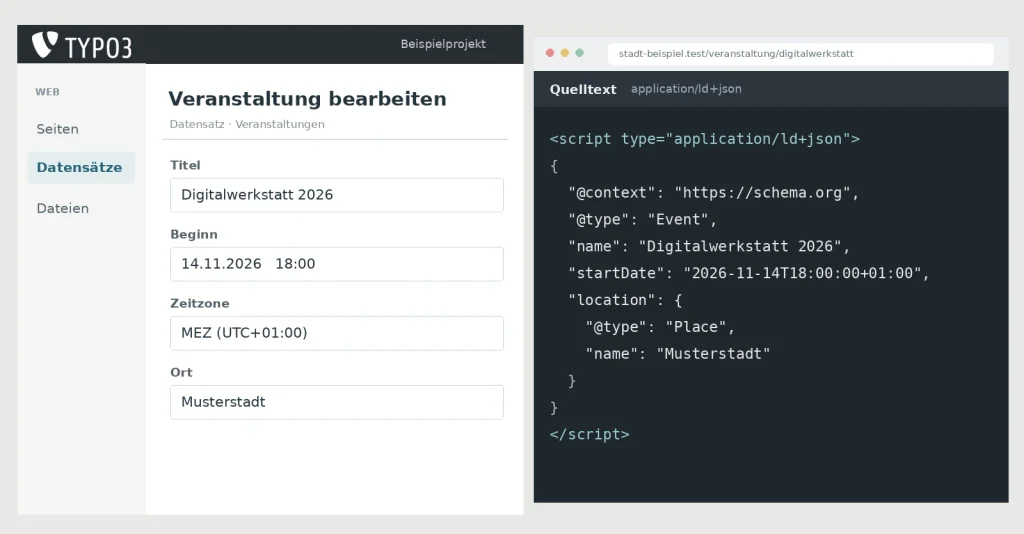
Strukturierte Daten nach Schema.org beschreiben im Quelltext maschinenlesbar, worum es auf einer Seite geht, etwa um eine Veranstaltung, eine Person oder ein Produkt, und zählen damit zu den vielversprechendsten Ansatzpunkten für GEO. Eine Studie aus dem Jahr 2026 hat getestet, wie genau KI-Systeme Fragen beantworten, wenn sie Inhalte mit strukturierten Daten abrufen [21]. Im Ergebnis wurden die Antworten präziser, wenn die strukturierten Daten mit sichtbaren Inhalten kombiniert waren: einer kurzen Zusammenfassung in normaler Sprache und Links zu verwandten Themen, Personen oder Orten auf derselben Website [21]. Für TYPO3 folgt aus der Studie, dass strukturierte Daten vor allem im Zusammenspiel mit sichtbar strukturierten Inhalten und sauber modellierten Datensätzen erstellt werden sollten.
Maschinenlesbarkeit ist zudem ein Infrastrukturthema: JSON-LD, das TYPO3 serverseitig in den Quelltext schreibt, steht Crawlern auch dann zur Verfügung, wenn einzelne Seitenbereiche per JavaScript nachgeladen werden. Google verlangt für die generativen KI-Funktionen der eigenen Suche kein spezielles Markup [4], dokumentiert strukturierte Daten aber weiterhin in einer eigenen Anleitung und nutzt die Daten nach eigener Aussage, um Seiteninhalte und Informationen über Personen, Unternehmen oder Bücher zu verstehen [22].
Strukturierte Daten sollten jedoch mit dem sichtbaren Seiteninhalt übereinstimmen. Als zentrale Herausforderung gilt die Synchronität zwischen strukturierten Daten und sichtbarem Inhalt, besonders bei Inhalten mit kurzen Lebenszyklen wie Fahrzeugangeboten [23]. In TYPO3 entstehen Abweichungen, wenn JSON-LD-Code von Hand in HTML-Inhaltselemente eingefügt wird und Redakteur*innen später nur den sichtbaren Text ändern. Die automatische Ausgabe strukturierter Daten aus Datensätzen und Seiteneigenschaften kann solche Abweichungen und den Pflegeaufwand verringern. Für llms.txt-Dateien ist die Lage offener: Google wertet llms.txt nach eigener Aussage zwar nicht aus [4], nutzt die Datei aber wie führende LLM-Anbieter selbst auf eigenen Themenseiten und berücksichtig diese bei Lighthouse-Reports, daher spricht einiges für die strategische Relevanz. Auch hier ist Dynamisierung im Hinblick auf sich ändernde Inhalte sinnvoll. Die Extension „ai-llms-txt“ unterstützt TYPO3 v13 und v14 [10], Websites auf älteren TYPO3-Versionen benötigen für diese Extension zuerst ein Upgrade.
Fünf Schritte können eine TYPO3-Website auf KI-Suchsysteme vorbereiten
- Zugang für KI-Crawler prüfen. Die robots.txt einer TYPO3-Website darf GPTBot, OAI-SearchBot, ClaudeBot und PerplexityBot nicht ausschließen, wenn die Inhalte in den Antworten dieser Systeme erscheinen sollen. Die KI-Anbieter betreiben jeweils eigene Crawler mit eigenen Regeln [23], daher ist jeder Crawler einzeln zu prüfen.
- Datenmodelle auf Schema.org abbilden und strukturierte Daten automatisch ausgeben. Die Extension „schema“ gibt Typen wie Organization, Person, WebPage und BreadcrumbList als JSON-LD aus und zeigt das erzeugte Markup im Admin-Panel zur Kontrolle an [8]. Eigene Datenmodelle wie Veranstaltungen oder Standorte benötigen eine projektspezifische Zuordnung zu Schema.org-Typen. Die Konfiguration über Site Sets kann die Ausgabe auf allen Seiten einheitlich halten [3].
- Autor*innen und Aktualisierungsdatum sichtbar machen. Empfohlen werden Autor*innenboxen mit Qualifikation und Foto sowie ein sichtbares Änderungsdatum [25]. Beide Angaben lassen sich gut in TYPO3 im Seiten- oder Beitragstemplate fest verankern.
- Inhalte passagenfähig schreiben. Jede Textpassage soll isoliert verständlich sein und die Kernaussage am Anfang tragen [3]. Eine Zusammenfassung von zwei bis drei Sätzen am Seitenanfang soll die Übernahme in KI-Antworten erleichtern [25]. Eine Zerlegung in sehr kurze Textstücke ist laut Google nicht erforderlich [4]. Auch wenn dies ein redaktionelles Thema ist, sollte es bei jeder TYPO3 Seite mitgedacht werden.
- llms.txt optional ergänzen. Die Extensions „ai-llms-txt“ und „llms-txt“ erzeugen die Datei automatisch aus Seitenstruktur und Metadaten [10].
FAQ zu GEO mit TYPO3
Braucht eine TYPO3-Website GEO? Auch wenn Google und führende Anbieter von LLMs sich mit Aussagen zu GEO zurückhalten ist es ein klarer Erfolgsfaktor und sollte berücksichtigt werden, gerade auch bei kommenden Updates/Upgrades. Welche Seiten. GEO für TYPO3 setzt bei den Faktoren an, die Organisationen selbst beeinflussen können: Zugang für Crawler, strukturierte Daten, Datenqualität und Textstruktur.
Braucht eine TYPO3-Website eine llms.txt-Datei? Da Google und führende LLM-Anbieter die Datei selbst einsetzen, besteht ein Anlass – sie ist ein emergenter Standard im zunehmend von AI-Bots durchkämmten Web. Für TYPO3 v13 und v14 erzeugen Extensions wie „ai-llms-txt“ die Datei mit geringem Aufwand [10], sodass ein Einsatz als Test vertretbar ist.
Ist ein Upgrade auf TYPO3 v14 Voraussetzung für GEO? Crawler-Zugang, Inhaltsstruktur, strukturierte Daten und Autor*innenangaben lassen sich auch ohne Upgrade auf v14 umsetzen, sofern die benötigten Extensions die eingesetzte Version unterstützen. TYPO3 v14 erleichtert die einheitliche Umsetzung durch Content Blocks als Standard für strukturierte Inhaltselemente [24].
Sind Headless-Websites mit TYPO3 für KI-Crawler lesbar? Headless-Websites mit TYPO3 gelten als lesbar für KI-Crawler, wenn das Frontend die Seiten serverseitig rendert. Lädt ein JavaScript-Frontend die Inhalte erst im Browser, sehen GPTBot und ClaudeBot diese Inhalte nach aktuellem Messstand nicht oder eingeschränkt [6, 7].
Fazit: TYPO3 bietet bereits eine technische Basis für GEO
TYPO3 bringt bereits eine gute technische Basis für GEO mit. Beispiele sind das serverseitige Rendering über Fluid, der mögliche Einsatz von Extensions und Automatismen im Core. Dies kann den Pflegeaufwand senken und helfen, semantische Angaben korrekt zu halten, weil sie aus den Daten im System entstehen. Strukturierte Daten zählen zu den vielversprechendsten Hebeln und sollten nach ersten Studienergebnissen zusammen mit sichtbar strukturierten Inhalten geplant werden [21]. TYPO3 v14.3 LTS erweitert die Möglichkeiten für Automatismen durch Content Blocks und zentral konfigurierte Site Sets. Passagenfähige Texte, sichtbare Autor*innen und aktuelle Daten können parallel mit darüber entscheiden, ob KI-Systeme eine TYPO3-Website als Quelle zitieren. Einen Überblick über das Leistungsangebot bietet die Seite zu den GEO-Leistungen von SinusQuadrat.
GEO mit TYPO3 und SinusQuadrat
Wir arbeiten seit über 15 Jahren mit TYPO3 und sind Silver Member der TYPO3 Association. Als TYPO3-Agentur entwickeln wir individuelle Extensions und Datenmodelle, übernehmen Upgrades und Updates, setzen Relaunches um, bilden Ihre Inhalte auf Schema.org ab, prüfen den Zugang für KI-Crawler und stimmen Inhaltselemente auf GEO ab.
Das machen wir gerne und sagen ehrlich, was geht – und was nicht.
Quellen
[1] W3Techs. (2026, 24. September). Usage statistics and market share of TYPO3.
[2] Bitkom. (2026, 28. April). Ein Drittel nutzt KI mindestens einmal pro Woche [Presseinformation].
[5] Kienast, A. (2026, 14. Juli). TYPO3 10.4.59, 11.5.53, and 12.4.48 ELTS released. TYPO3 News.
[10] web-vision. (2025, 26. November). Make TYPO3 AI-ready now with LLMs.txt.
[11] Yoast. (o. J.). llms.txt: Yoast SEO features.
[12] TYPO3 Documentation Team. (o. J.). Features: TYPO3 CMS SEO. TYPO3 Documentation.
[13] Williams, J. (2026, 27. Juli). WPML vs TranslatePress vs Weglot vs Polylang. Odd Jar.
[14] Cloudflare. (2026, 12. Februar). Introducing Markdown for Agents [Changelog].
[15] b13. (2026, 28. Januar). The internet is no longer just for humans: AI bots love markdown.
[19] Zuplo. (2026, 13. März). What is WebMCP?
[20] Nägler, F. (2026). WebMCP tool for TYPO3 [Dokumentation]. TYPO3 Documentation.
[22] Google. (2025, 10. Dezember). Intro to how structured data markup works. Google Search Central.
[24] netthinks. (2026). TYPO3 v14.3 LTS: An overview of the most important new features.
[25] János, A. (2025, 7. November). Sieben redaktionelle Tipps zur KI. supseven.